KI · 2.5 Referenzbilder
Was Referenzbilder leisten
Ein Porträt, ein Produktfoto, ein Prompt — und ein Modell, das versteht, was es woraus nehmen soll.
Vier Wege ins Modell
Wer aus der Cloud kommt, kennt einen Weg: Bilder hochladen und im Prompt sagen, was damit geschehen soll. Die Frau von hier, die Hose von dort, das Licht wie auf dem dritten Bild. Ob ein Bild Identität, Komposition oder Stil liefert, entscheidet der Satz dazu.
Lokal ist das nicht selbstverständlich. Ein Bild kann auf vier Wegen ins Modell kommen. Bei dreien davon entscheidet nicht der Prompt, was es bewirkt, sondern die Stelle im Workflow, an der es angeschlossen ist. Die Wege werden oft durcheinandergeworfen, am häufigsten mit img2img.
img2img — übermalen
Das Bild wird zum Ausgangspunkt. Das Modell rechnet nicht aus leerem Rauschen, sondern aus dem angerauschten Bild und malt darüber. Wie viel stehen bleibt, regelt Denoise. Komposition, Farben und Formen kleben an der Vorlage. Gut zum Variieren und Veredeln, ungeeignet, um eine Person oder ein Produkt in ein neues Bild zu holen.
ControlNet — festlegen
Ein Vorprozessor zieht aus dem Bild nur die Struktur heraus: Kanten, Tiefe oder Pose. Die Erscheinung bleibt draußen. Was das Bild bewirkt, legt der Vorprozessor fest, nicht der Prompt. So arbeitet RAY-L.
Adapter — zusammenfassen
IP-Adapter und Redux verdichten das Bild über einen Bild-Encoder zu einer Zusammenfassung in Zahlen und speisen sie über nachträglich trainierte Gewichte ins Modell. Die Stärke lässt sich regeln, die Wirkung per Maske begrenzen. „Nur die Hose aus diesem Foto“ lässt sich nicht sagen. Und weil die Zusammenfassung Details verliert, wird eine Person eher ähnlich als dieselbe.
In-Context — lesen
Das Bild läuft durch dieselbe Kodierung wie das Bild, das gerade entsteht, und liegt in voller Auflösung daneben. Das Modell ist darauf trainiert, es zu lesen. Das neue Bild entsteht trotzdem frisch, auf leerer Leinwand. Nur auf diesem Weg entscheidet der Prompt, was übernommen wird, und nur dieser Weg fühlt sich an wie das, was man aus der Cloud kennt. So arbeiten Flux.2 Klein und Flux.3 Klein.
Übersetzt ans Set: img2img ist das Übermalen eines alten Abzugs. ControlNet ist die Markierung auf dem Boden: Hier stehst du, genau hier. Der Adapter ist das Moodboard an der Wand, alle sehen es, keiner weiß genau, was davon gemeint ist. In-Context ist die Vorlage, die man dem Model in die Hand gibt, mit dem Satz dazu: die Frisur von hier, die Hose von da.
Der Workflow auf dieser und der nächsten Seite nutzt den vierten Weg. Wer aus Gewohnheit img2img sagt und eine Referenz meint, schließt das Bild am falschen Eingang an. Es wird dann übermalt statt gelesen.
Zwei Referenzen, ein Prompt
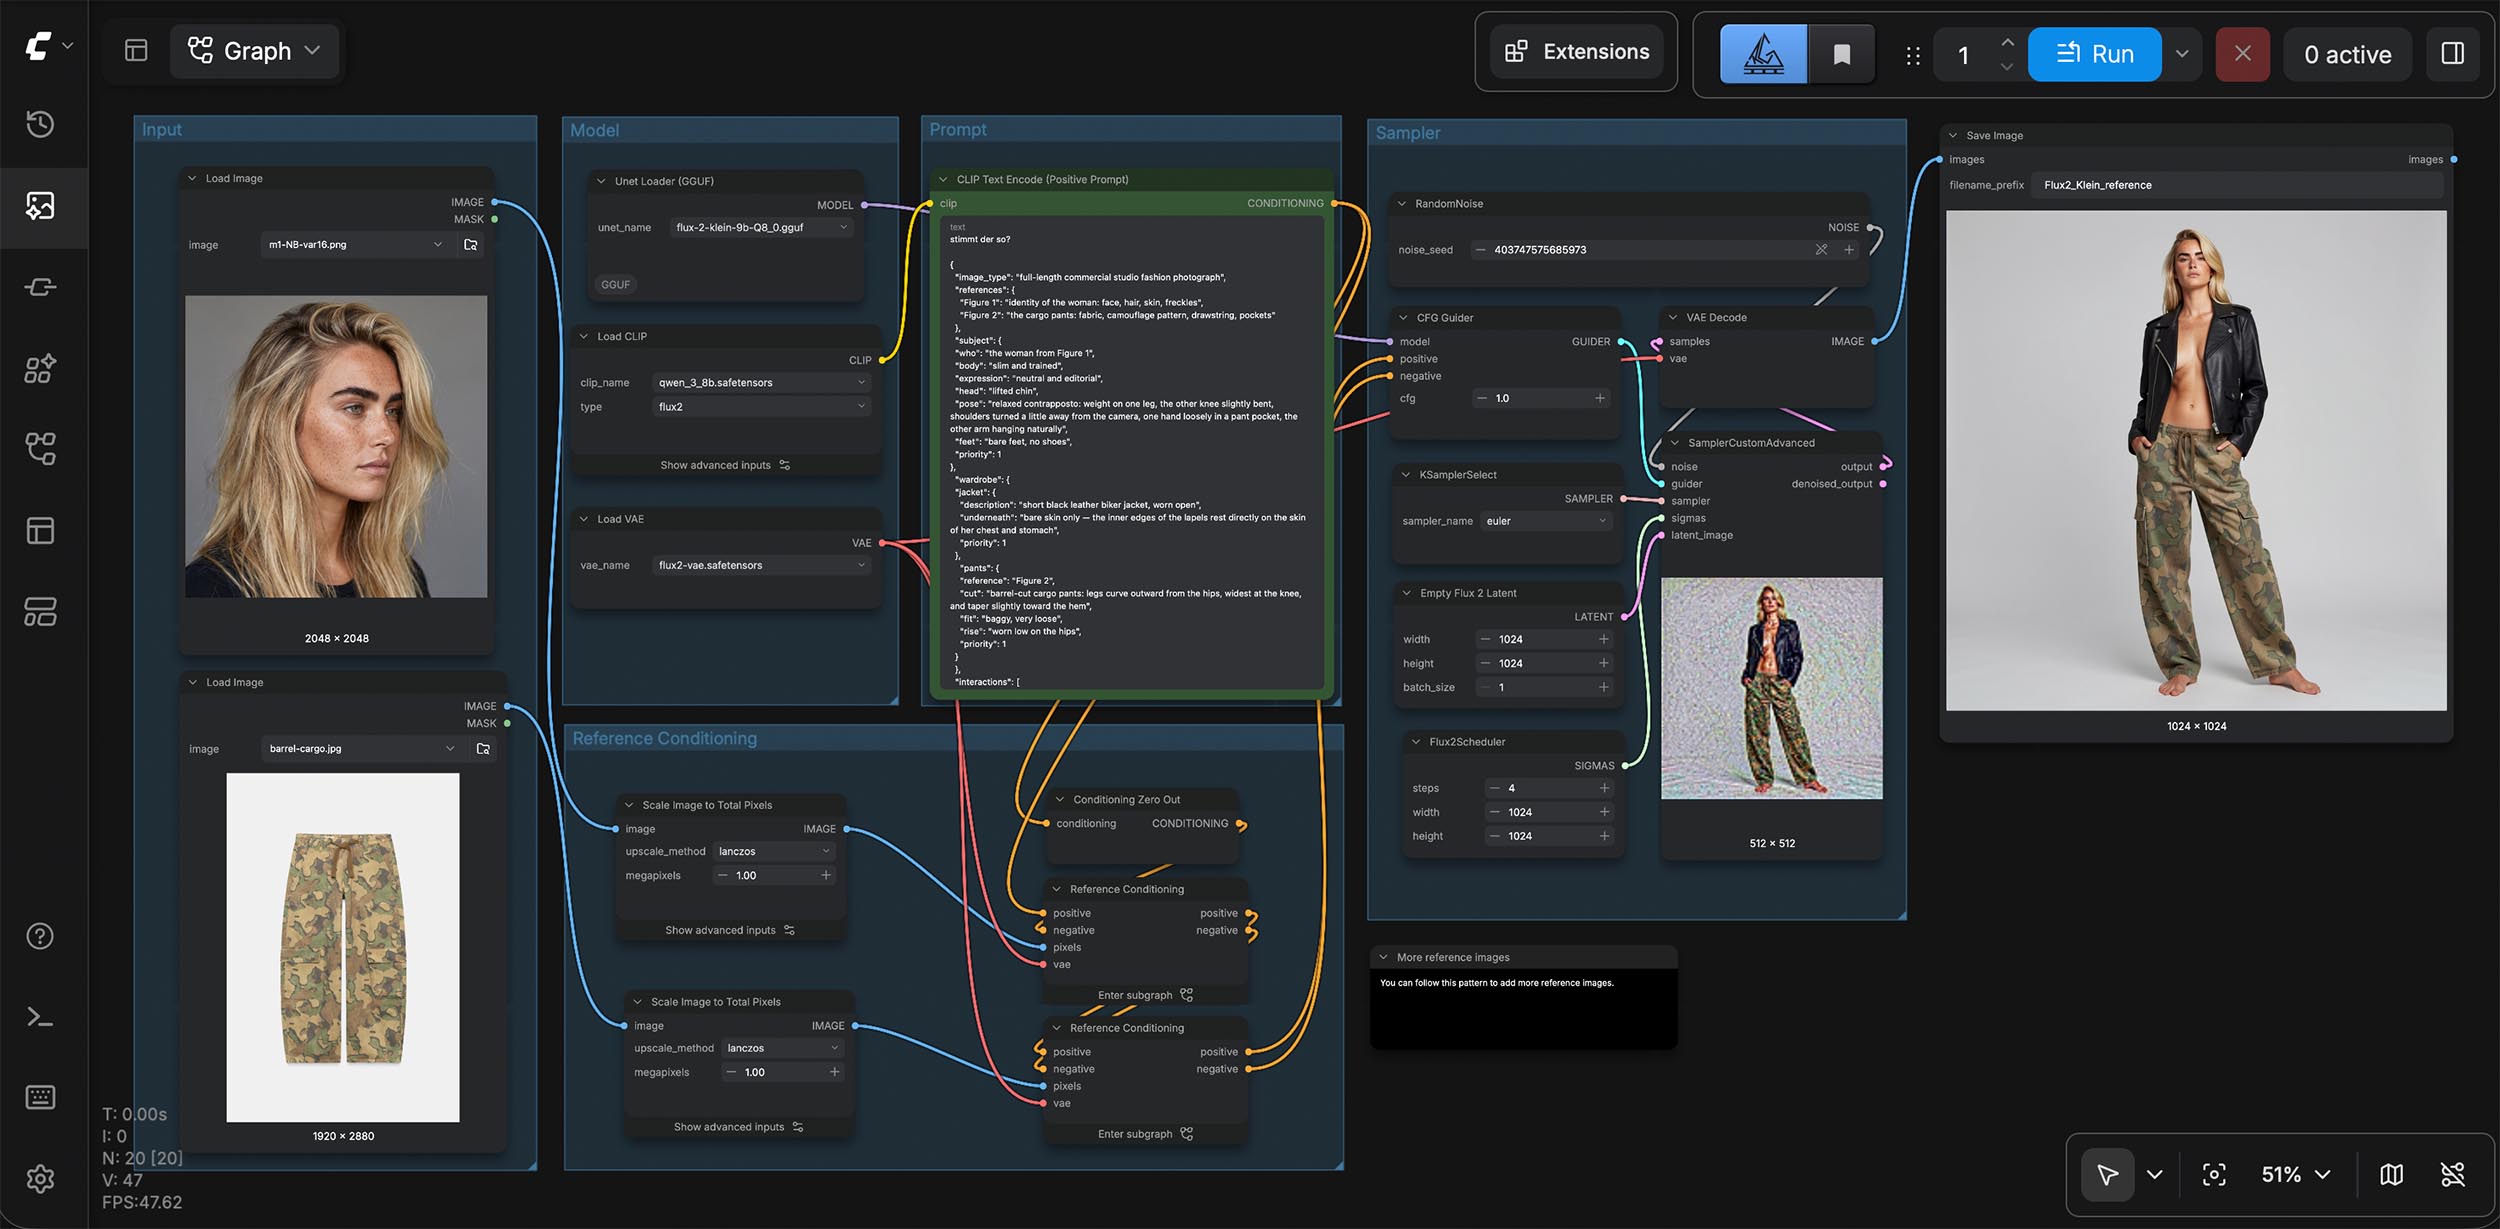
Die Frau stammt aus meinem Bildfundus, den ich gerade als Trainingsmaterial für ein Character-LoRA zusammenstelle. Die Person ist vollständig generiert: Das erste Bild ist aus einem Prompt entstanden, ohne Bildvorlage. Alle weiteren sind Variationen dieses Basis-Characters. Aus diesem Fundus habe ich eine Reihe Aufnahmen mit unterschiedlicher Frisur und unterschiedlichem Make-up generiert.
Weil die Person vollständig generiert ist, berührt sie keine Persönlichkeitsrechte Dritter. Mehr dazu in 2.7.3 Persönlichkeitsrecht.
Die Hose ist echt: ein Produktfoto, wie es jeder Onlineshop hat, flach liegend, freigestellt, ohne Körper darin. Porträt und Produktfoto liegen im Workflow als Referenz, Figure 1 und Figure 2. Aus den beiden Referenzbildern und dem dazugehörigen Prompt ist die Modeaufnahme darunter entstanden. Die Frau stammt aus dem Porträt, die Hose aus dem Shop, die Lederjacke allein aus dem Prompt.
Das Zusammenspiel dieser Komponenten ergibt einen glaubwürdigen Modelshot. Auf dem Produktfoto ist der Schnitt der Hose zwar zu erahnen, es lässt aber wenig Rückschluss darauf zu, wie sie getragen sitzt. Diese Information muss in den Prompt. Sie sollte unterstützen, was auf dem Bild zu sehen ist, denn wo sie dagegen läuft, kann es zu Konflikten kommen. Getragen sitzt sie tief auf der Hüfte, fällt weit und bauchig und steht auf dem Fuß auf — so, wie sie im Lookbook der Marke getragen wird.
Darum geht es in diesem Kapitel. Nicht darum, ein Bild nachzumalen, sondern darum, dass ein Modell versteht, was es aus einem Bild übernehmen soll.
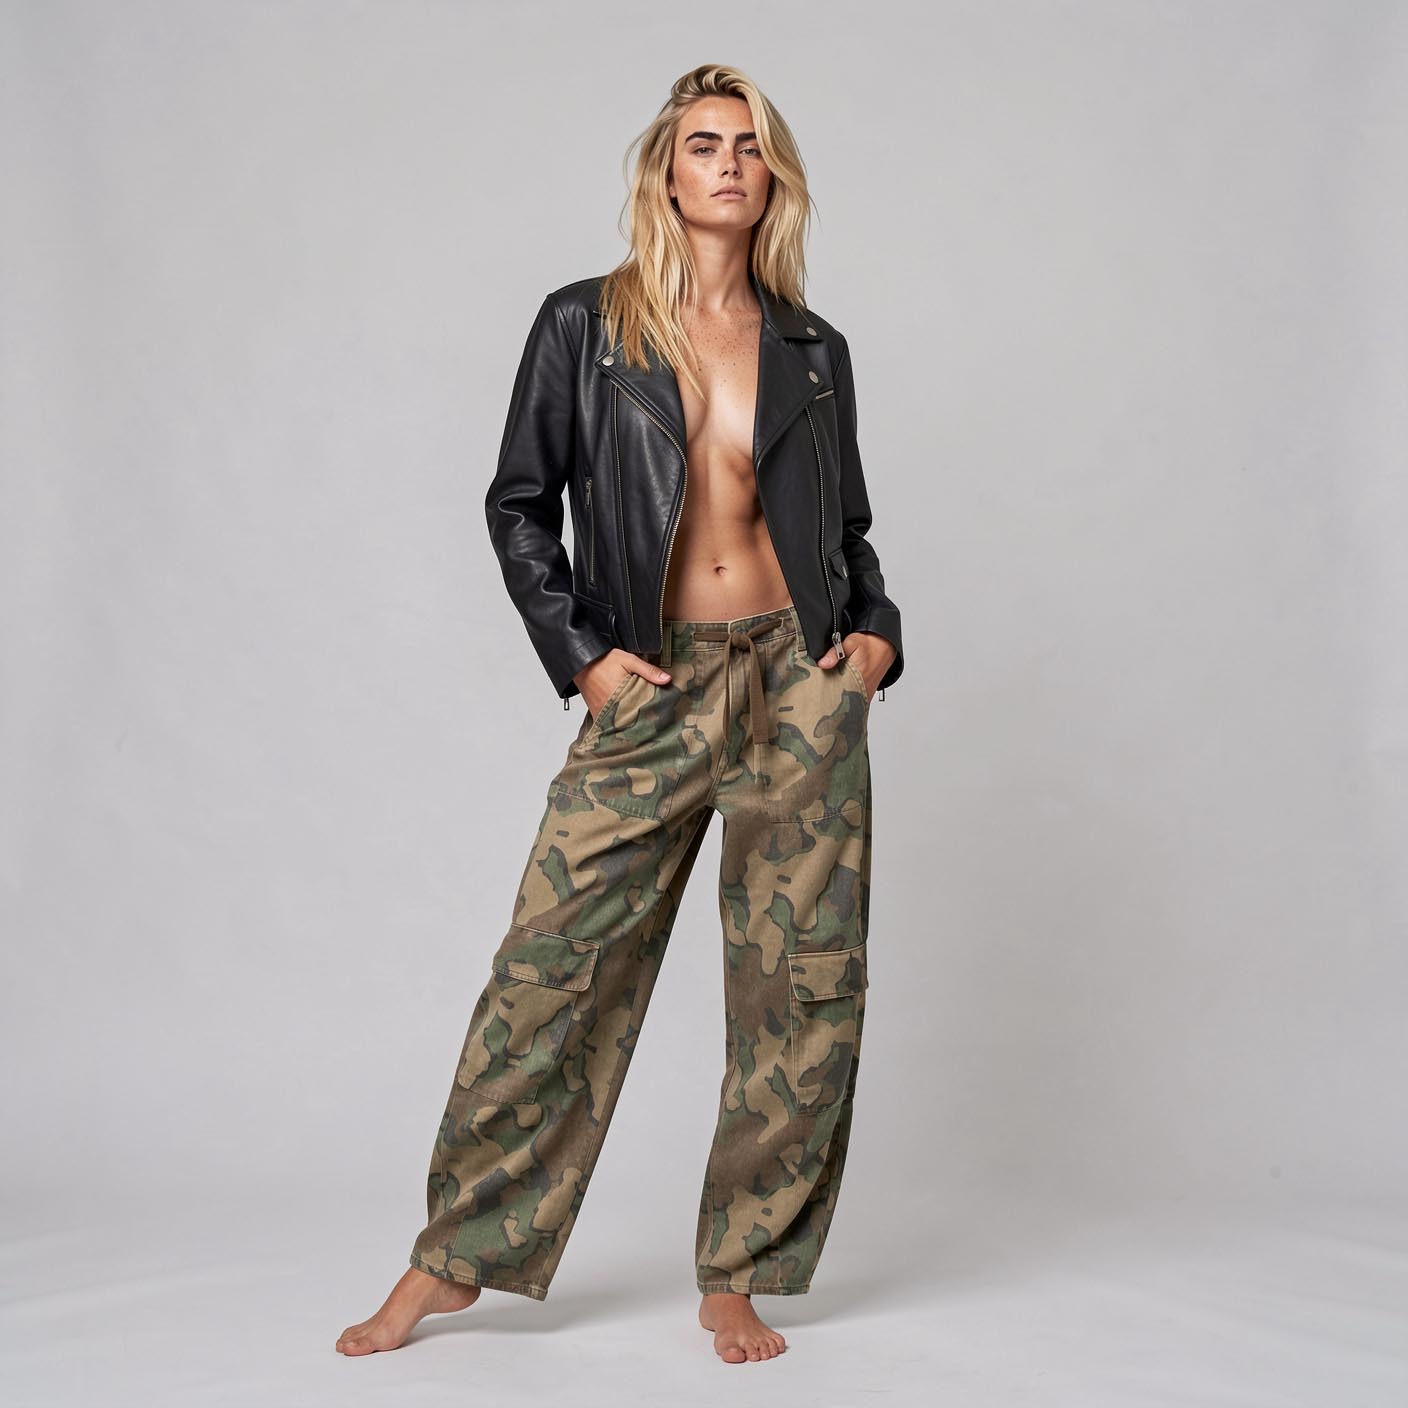
Flux.2 Klein 9B · 1408 × 1408 · 8 Steps
Was eine Referenz mitbringt
Aus dem Porträt kamen Gesicht, Sommersprossen, Brauen und Haarfarbe. Und die Frisur, die im Prompt gar nicht stand. Aus dem Produktfoto kamen Stoff, Tarnmuster in genau dieser Farbstellung, die braune Kordel, die Cargotaschen. Weder „camouflage“ noch „drawstring“ stehen im Prompt. Muster und Kordel sind trotzdem da. Deutlicher lässt sich nicht zeigen, dass das Modell die Referenz liest. Dass man sich darauf nicht immer verlassen kann, zeigt 2.5.2.
Eine Referenz liefert, was auf ihr zu sehen ist. Nicht mehr. Das gilt für jedes Produkt. Ein Herstellerfoto zeigt immer einen bestimmten Zustand — liegend, auf dem Bügel, freigestellt, unbenutzt. Wie das Produkt im Bild sein soll, getragen, eingesessen, aufgeklappt, beschreibt der Prompt.
Die beiden Produktfotos, so wie sie als Figure 2 in den Workflow gehen. Flach liegend, ohne Körper, ohne Hinweis darauf, wie die Hose getragen sitzt.
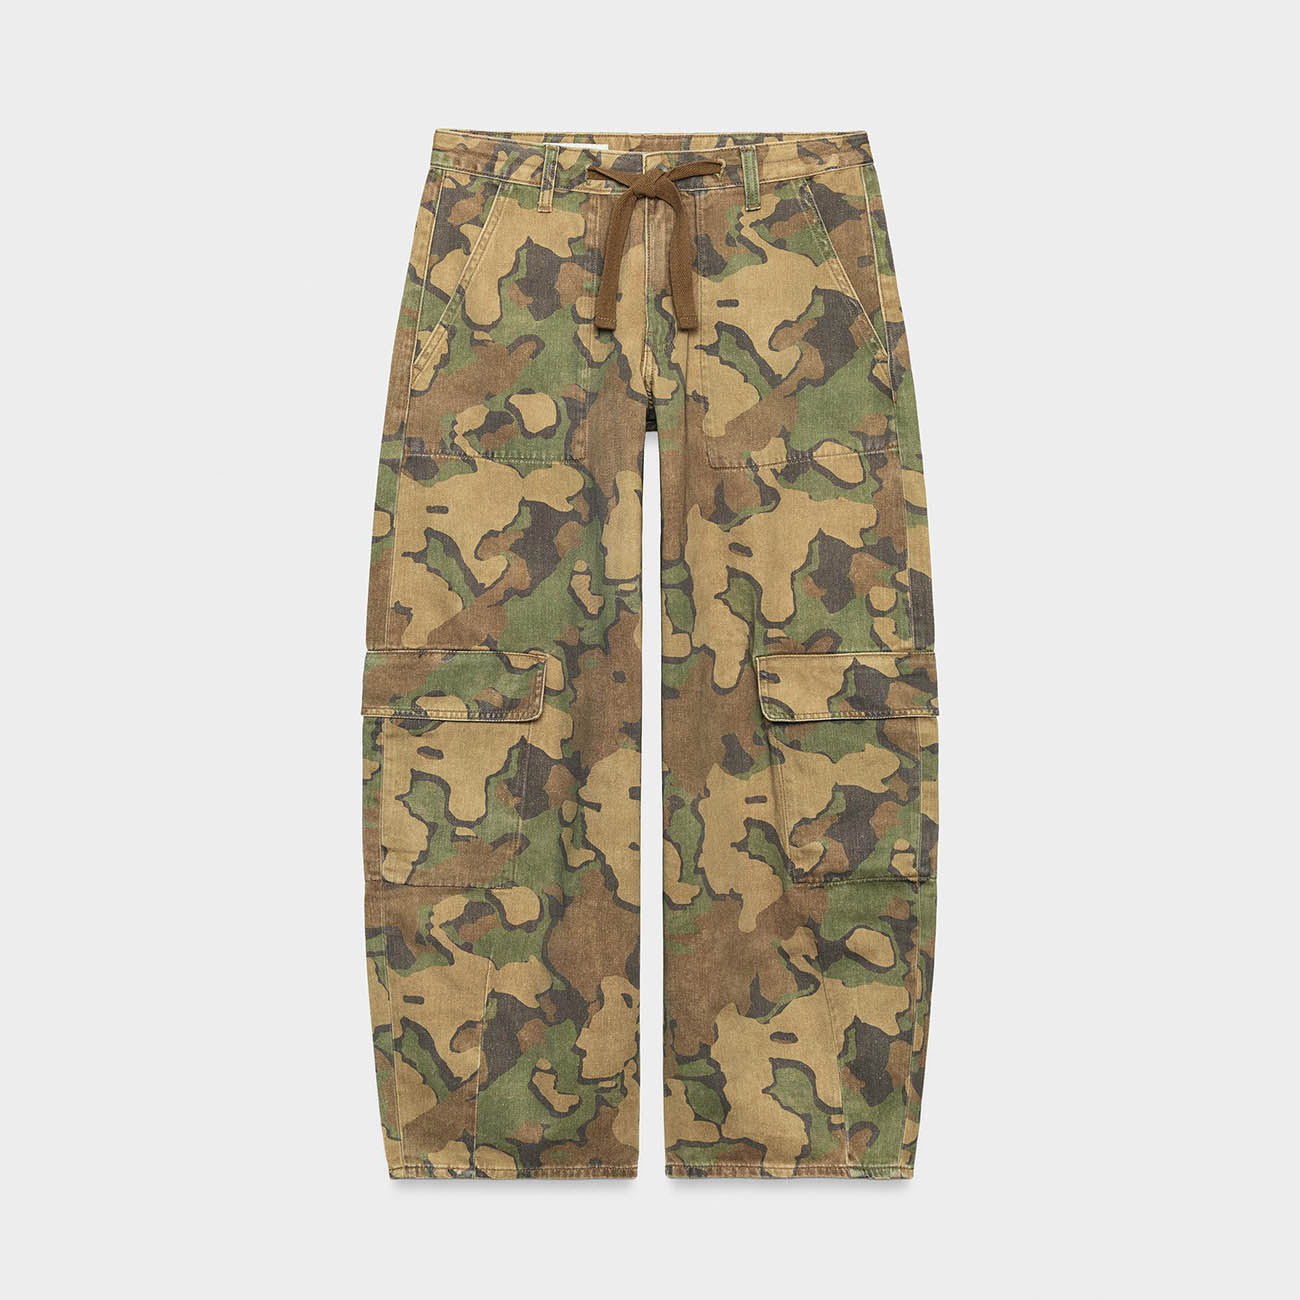
Figure 2 · Cargohose
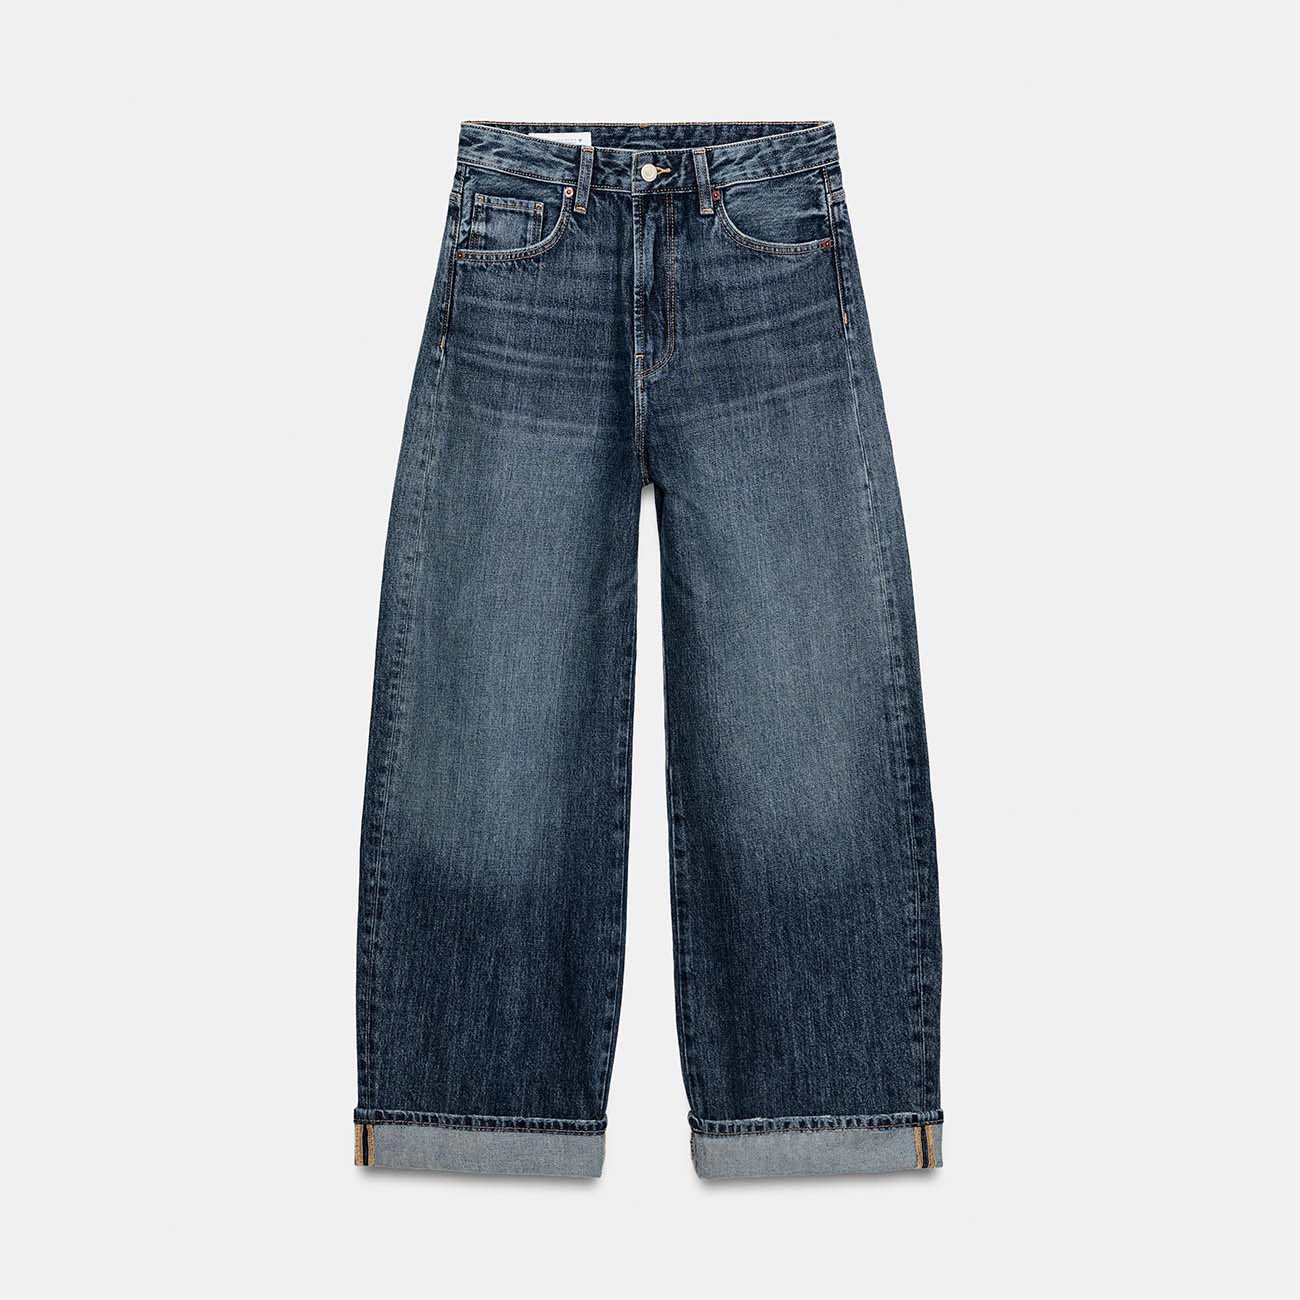
Figure 2 · Jeans
Produktfotos: Zara · www.zara.com
Wie direkt eine Referenz wirkt, zeigt ein einfacher Tausch. Gleicher Prompt, gleicher Seed, gleiche Steps. Getauscht wird jeweils nur eine Referenz: das Porträt, dieselbe Frau mit offenem oder hochgestecktem Haar, und das Produktfoto, Cargohose oder Jeans. Pose, Licht und Jacke bleiben in allen vier Bildern stehen. Es ändert sich, was die neue Referenz vorgibt.
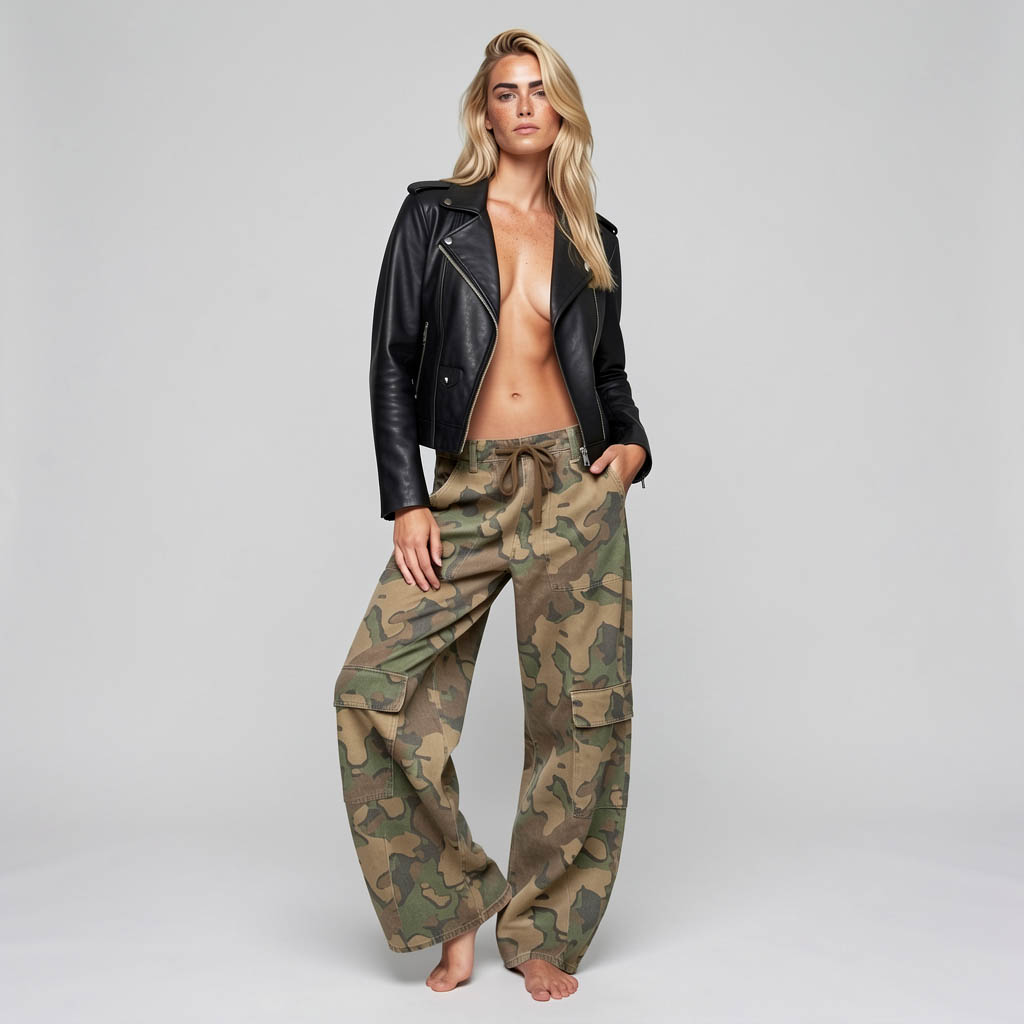
Offenes Haar · Cargohose
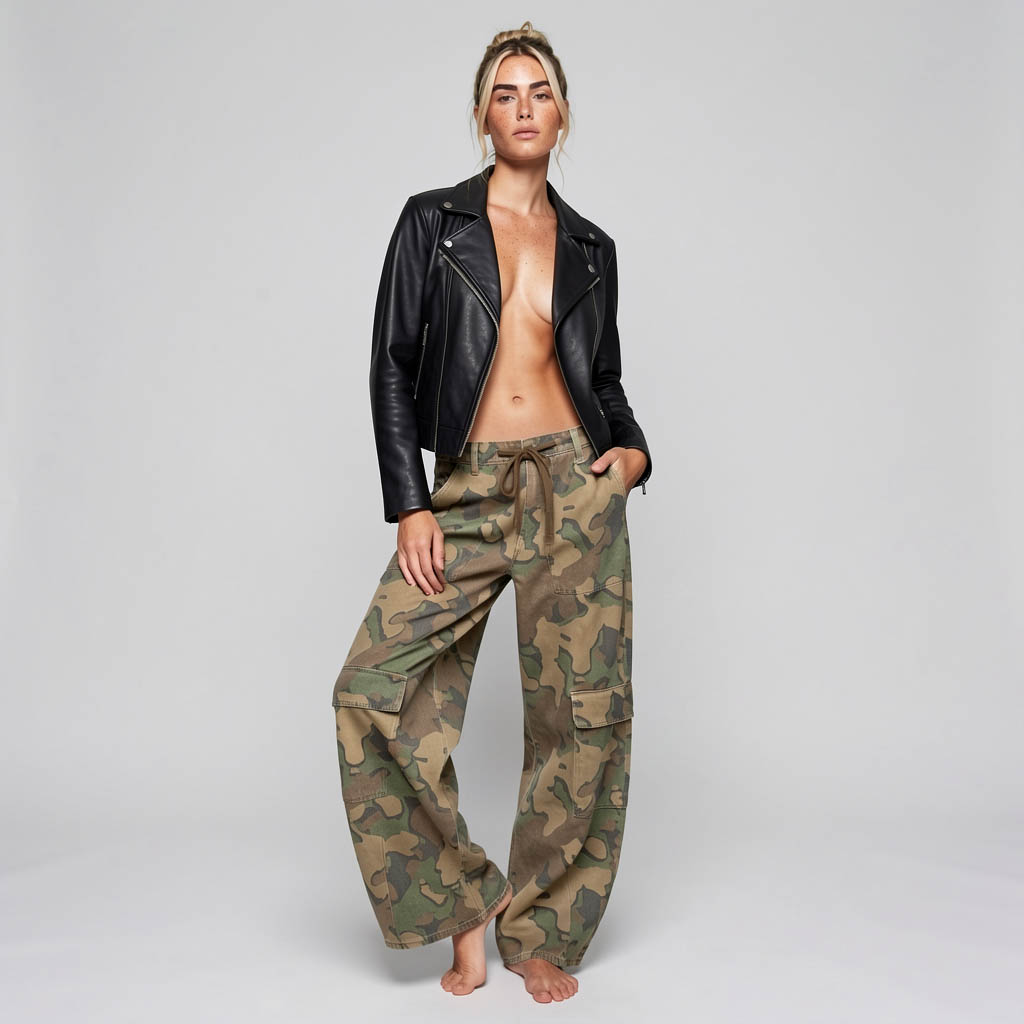
Hochgesteckt · Cargohose
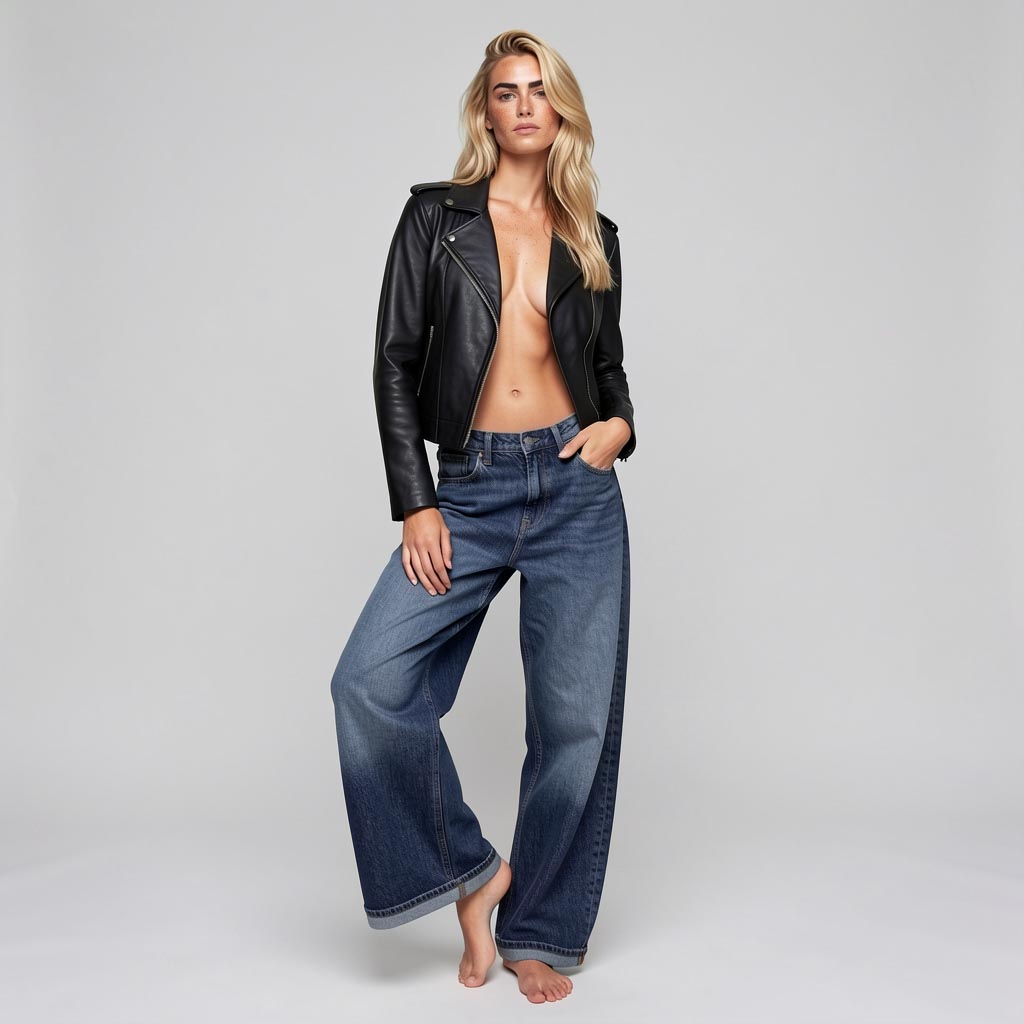
Offenes Haar · Jeans
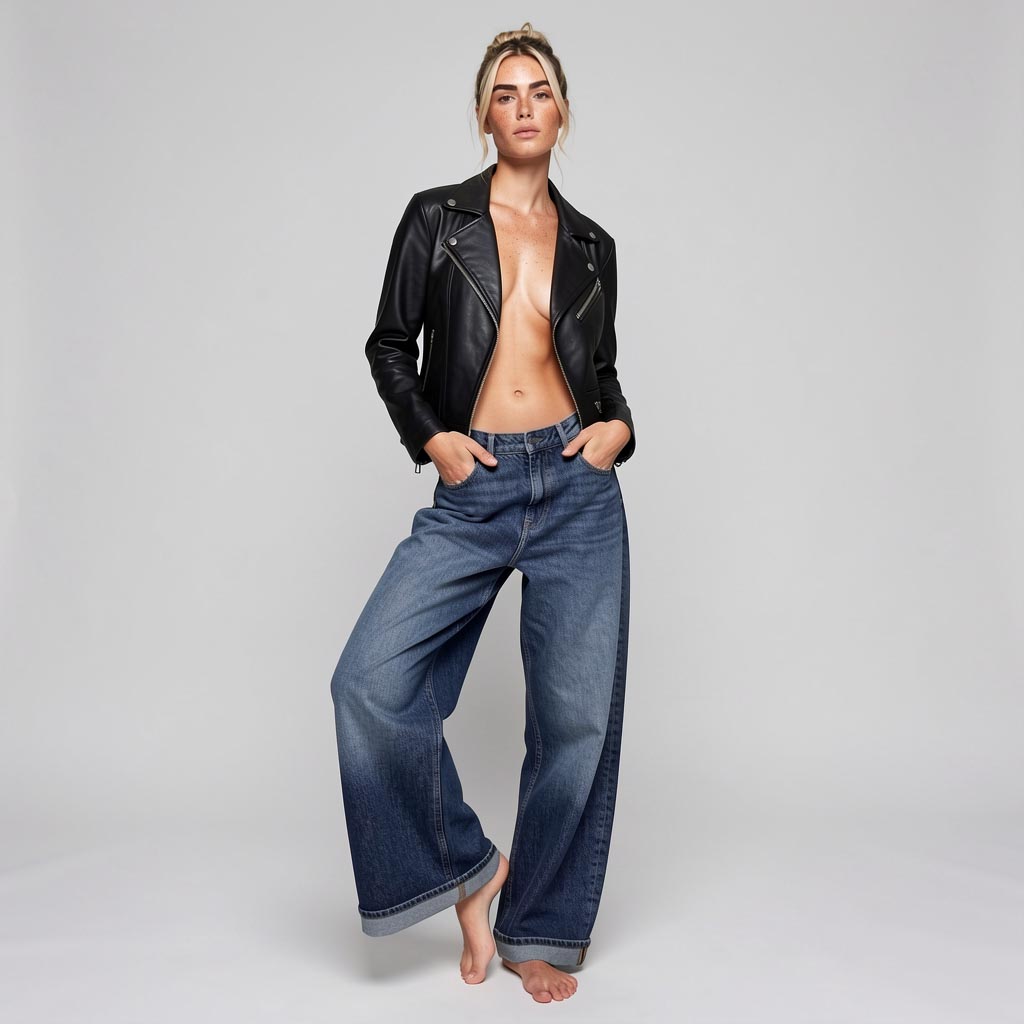
Hochgesteckt · Jeans
Fast. Drei von vier Bildern halten die Pose bis zur Hand. Im vierten stecken beide Hände in den Taschen, obwohl der Prompt eine frei lässt. Weder die Frisur noch die Jeans allein lösen das aus, erst beide zusammen. Jede Referenz wirkt auf das ganze Bild, nicht nur auf das, wofür sie gedacht ist. Was im Prompt nur knapp entschieden ist, kann in einer Kombination umkippen, die einzeln hält.
Festlegen oder vorgeben
Naheliegend wäre die Aufteilung: Die Referenz bestimmt, wie etwas aussieht, ControlNet bestimmt, wo es steht. So sauber ist es nicht. Eine Referenz kann auch eine Pose tragen — ein drittes Bild, und im Prompt der Hinweis, dass nur die Haltung daraus übernommen werden soll. Ob das ohne Übersprechen funktioniert, ohne dass Kleidung oder Gesicht der Posenvorlage mitwandern, teste ich gerade.
Der eigentliche Unterschied liegt in der Verbindlichkeit. ControlNet legt fest. Kanten oder Tiefe werden pixelgenau übernommen, die Perspektive deckt sich mit der Vorlage. Eine Referenz gibt vor. Das Modell interpretiert sie, so wie ein Model eine Posenvorlage nachstellt: sinngemäß, nicht deckungsgleich.
Für ein Modefoto reicht das. Für ein Sofa, das in eine Blender-Szene mit festgelegter Perspektive muss, reicht es nicht. Referenzbilder ersetzen ControlNet also nicht, sie ergänzen es. Deshalb arbeitet RAY-L mit ControlNet. Und wer beides braucht, eine festgelegte Geometrie und ein bestimmtes Produkt darin, kombiniert beides — darum geht es in 2.5.4.
Der Prompt führt Regie
Bei Flux.2 Klein bekommen Referenzbilder Namen: Figure 1, Figure 2, in der Reihenfolge, in der sie im Workflow hängen. Der Prompt verteilt die Rollen. For the identity of the woman use Figure 1. As reference for the pants use Figure 2. Das klingt banal und ist der eigentliche Wechsel. Das Referenzbild ist keine Stimmung mehr, die irgendwie ins Bild sickert, sondern Material, auf das sich die Sprache beziehen kann.
Das hat eine Kehrseite, die ich bei der Umstellung auf einen JSON-Prompt gelernt habe. Wer festlegt, was sichtbar sein muss — die Haut zwischen den offenen Jackenseiten, beide Hosenbeine bis zum Boden —, legt damit auch fest, wie die Person stehen muss. Plötzlich stand sie bei jedem Seed breitbeinig, mit hängenden Armen. Erst eine konkret beschriebene Pose hat das gelöst: Standbein, Spielbein, eine Hand in der Tasche.
Wie solche Prompts aufgebaut werden, steht in der Promptschule. Der vollständige Prompt, zur Variante mit Camouflage Cargo:
Prompt anzeigen · JSON +
{
  "image_type": "full-length commercial studio fashion photograph",
  "references": {
    "Figure 1": "identity of the woman: face, hair, skin, freckles",
    "Figure 2": "the cargo pants: fabric"
  },
  "subject": {
    "who": "the woman from Figure 1",
    "body": "slim and trained",
    "expression": "neutral and editorial",
    "head": "lifted chin",
    "pose": "relaxed contrapposto: weight on one leg, the other knee slightly bent, shoulders turned a little away from the camera, one hand loosely in a pant pocket, the other arm hanging naturally",
    "feet": "bare feet, no shoes",
    "priority": 1
  },
  "wardrobe": {
    "jacket": {
      "description": "short black leather biker jacket, worn open",
      "underneath": "bare skin only — the inner edges of the lapels rest directly on the skin of her chest and stomach",
      "priority": 1
    },
    "pants": {
      "reference": "Figure 2",
      "cut": "barrel-cut cargo pants: legs curve outward from the hips, widest at the knee, and taper slightly toward the hem",
      "fit": "baggy, very loose",
      "rise": "worn low on the hips",
      "priority": 1
    }
  },
  "interactions": [
    "the open jacket ends at the waist and falls loosely open over bare skin",
    "the wide pant legs fall to the floor and rest on the bare feet"
  ],
  "setting": {
    "backdrop": "seamless pale grey studio backdrop",
    "priority": 3
  },
  "lighting": {
    "key": "large soft diffused key light",
    "priority": 2
  },
  "style": {
    "palette": "neutral",
    "quality": "clean high-end fashion catalogue",
    "priority": 2
  }
}
Welches Modell was kann
Flux.2 Klein 9B liest Referenzbilder ohne Zusatzmodell, mit demselben Setup und denselben Parametern wie ohne Referenz. Flux.2 Klein 4B kann das genauso. Auf dem MacBook Air mit 16 GB werden beide Referenzen eingearbeitet wie beim 9B. Die Farben sind blasser, feine Details und die Umsetzung des Prompts bleiben deutlich hinter dem größeren Modell zurück. Das liegt an der Modellgröße, nicht am Rechner. Als Q8-GGUF braucht ein Bild bei 1024 × 1024 und 4 Steps knapp sechs Minuten. Damit läuft der ganze Workflow auf 16 GB und unter Apache 2.0. Die undistillierten Base-Varianten von Flux.2 Klein dagegen ignorieren Referenzen vollständig: Bei gleichem Seed kam mit und ohne Referenz ein pixelidentisches Bild heraus. Flux.3 Klein liest Referenzbilder ebenfalls ohne Adapter, nach demselben Prinzip, nur mit eigenem Setup.
Flux.1 dev, Flux.1 Krea dev und SDXL können Referenzbilder nicht von sich aus lesen. Dort bleibt der Adapter. Dafür haben diese Modelle, was Flux.2 Klein in ComfyUI bisher fehlt: ControlNet.
Daraus ergibt sich die Reihenfolge der nächsten Seiten. 2.5.2 zeigt Setup und Workflow für Flux.2 Klein und Flux.3 Klein. 2.5.3 behandelt die Adapter für Modelle ohne eingebaute Referenz, 2.5.4 die Kombination mit ControlNet.