Säule 3 · RAY-L
Was RAY-L ist
RAY-L verbindet Blender und ComfyUI. Es überträgt die Geometrie einer Blender-Szene als Kantenstruktur an ein KI-Bildmodell, über ControlNet Canny — und sorgt so dafür, dass Komposition, Perspektive und Objektplatzierung exakt erhalten bleiben, während die KI Materialien, Licht und Atmosphäre interpretiert.
Das ist die technische Beschreibung. Die eigentliche Frage ist eine andere: warum braucht es das überhaupt?
Was RAY-L nicht ist: ein weiterer Weg, beeindruckende KI-Bilder zu erzeugen. Davon gibt es bereits genug, und die meisten davon sind ein Verhandlungsergebnis mit einem System, das eigene Vorstellungen hat — manchmal überraschend gut, manchmal überraschend schlecht, nie wirklich vorhersehbar. Für Hobbyanwender und schnelle Ideenfindung ist das oft genug. Für professionelle Bildproduktion nicht.
Was RAY-L ist: ein Weg, KI-Bildgenerierung in einen Workflow einzubinden, der professionellen Anforderungen standhält. Nicht durch noch präzisere Prompts — das versucht, ein stochastisches System in ein deterministisches zu verwandeln, und nimmt der KI dabei genau das, was sie stark macht. Sondern durch eine bewusste Aufteilung: was muss exakt festgelegt sein, und was darf interpretiert werden.
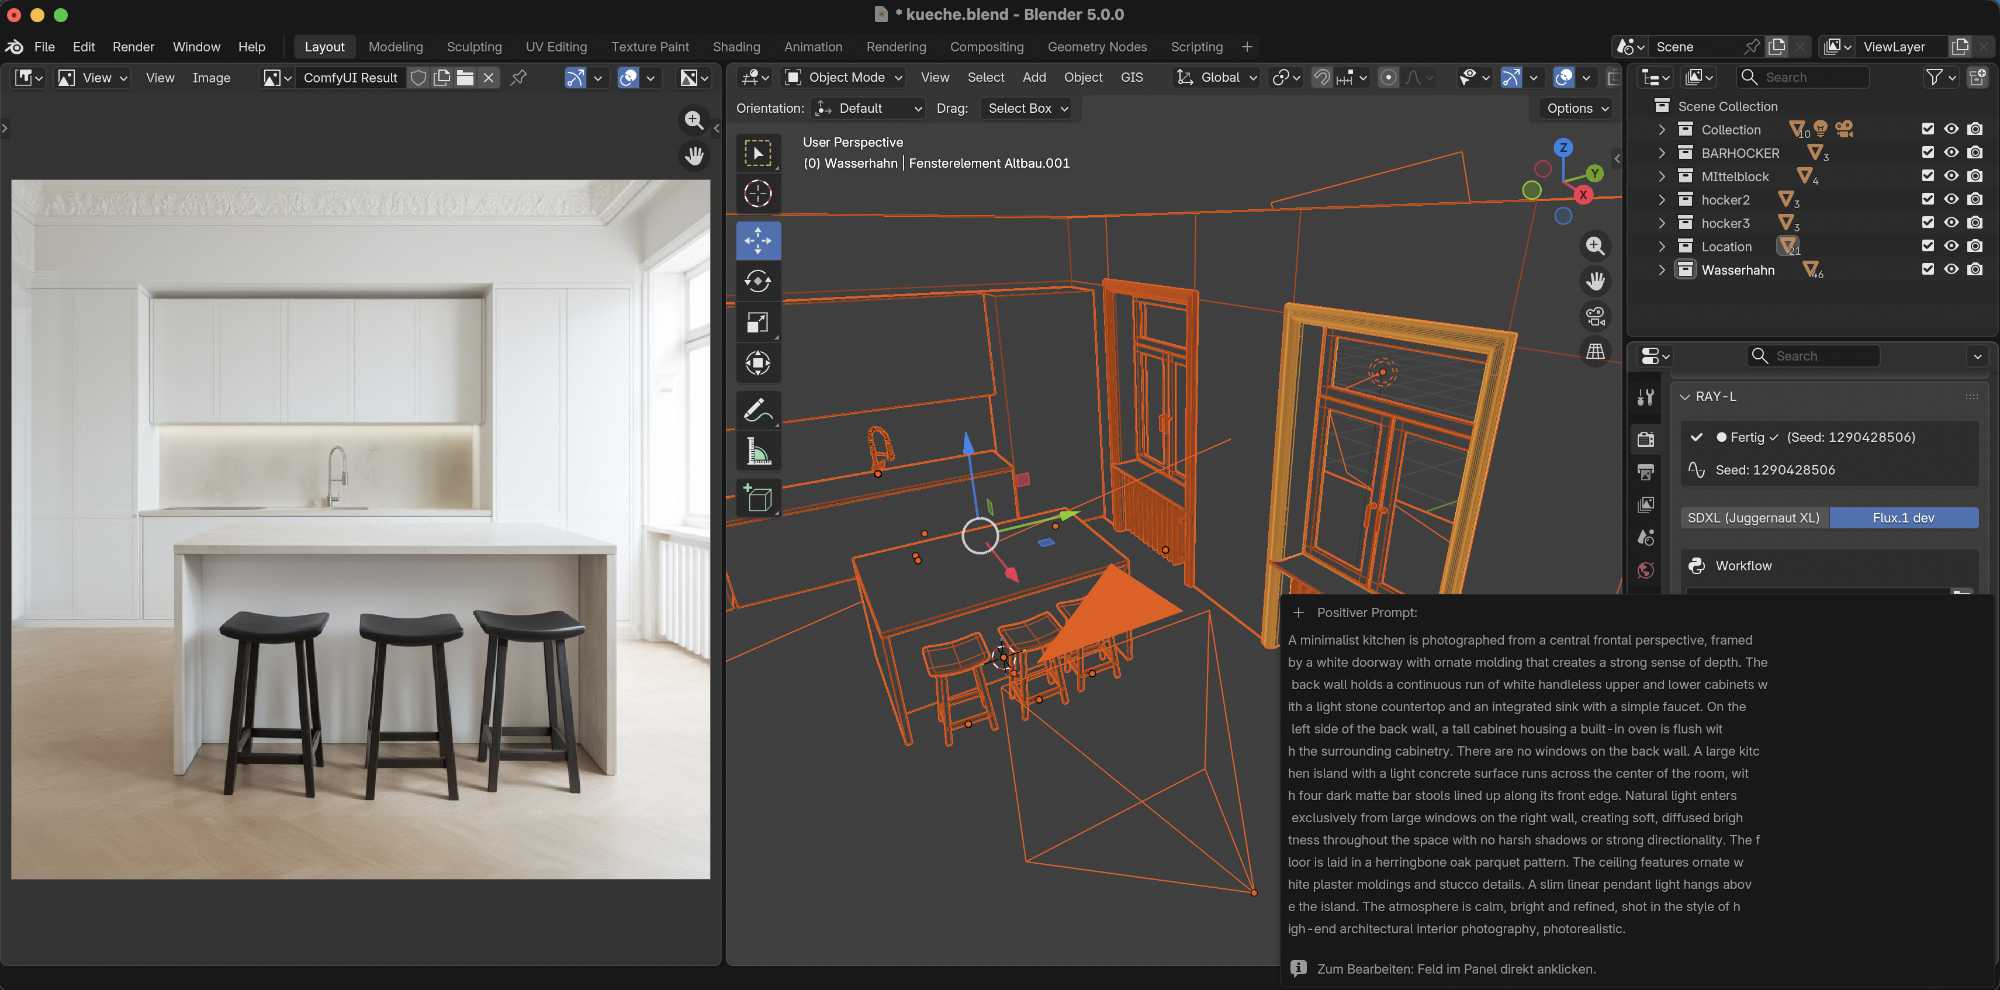
Die Aufteilung, die RAY-L technisch umsetzt
Diese Aufteilung ist nicht neu erfunden — sie ist das Kernprinzip, das auf dieser Website im Concept-Bereich ausführlich hergeleitet wird. RAY-L ist die technische Umsetzung dieses Prinzips:
Blender legt fest: Kamera, Perspektive, Geometrie, Objektplatzierung, räumliche Beziehungen. Alles, was bei einer Wiederholung exakt gleich bleiben muss — heute, in sechs Monaten, mit einem anderen Material oder einer anderen Stimmung.
Die KI interpretiert: Materialanmutung, Lichtstimmung, Atmosphäre, Oberflächendetails. Alles, was von Bild zu Bild variieren darf, ohne dass die Kernaussage des Bildes verloren geht.
RAY-L ist die Brücke zwischen beiden — ein Blender-Add-on, das die Geometrie der aktiven Szene aufbereitet und an ComfyUI übergibt, wo ein Diffusionsmodell mit ControlNet Canny daraus das finale Bild generiert.
Warum ControlNet Canny
ControlNet Canny überträgt ausschließlich Kantendaten — keine Lichtfarbe, keine Stimmung, keine Materialinformation. Genau diese Beschränkung ist der Grund, warum es für RAY-L die richtige Wahl ist: Sie gibt der KI eine verbindliche räumliche Struktur vor, ohne ihr gleichzeitig vorzuschreiben, wie sie diese Struktur visuell ausarbeitet.
Was in Blender kompositorisch korrekt sitzt, sitzt im Ergebnis korrekt. Eine schwache Komposition lässt sich durch die KI atmosphärisch kompensieren — aber kompensiert ist nicht korrigiert. Für ein stimmungsvolles Bild ohne strenge Anforderungen kann die KI viel retten. Für ein Produktfoto, das eine exakte Position im Bild, eine bestimmte Größe und eine vorgegebene Perspektive braucht, gibt es dafür keinen Ersatz.
Wie genau ControlNet Canny dabei funktioniert — und warum gerade diese Variante und nicht eine andere — folgt in einem eigenen Artikel.
Erweiterbar über eigene ComfyUI-Workflows
RAY-L verbindet Blender und KI-Bildgenerierung in beide Richtungen: Es steuert nicht nur ComfyUI, sondern übernimmt auch Workflows, die dort aus dem RAY-L-Workflow heraus erweitert werden.
Seit Version 0.9 lässt sich der ComfyUI-Workflow um beliebige Nodes erweitern, als JSON speichern und in RAY-L als externen Workflow importieren. Bei der Bildgenerierung wird dann der komplette Workflow mit allen zusätzlichen Nodes berücksichtigt — nicht nur der Canny-Pfad.
So bleibt die Pipeline offen für alles, was ComfyUI kann: einen Upscaler, der das Ergebnis direkt in höherer Auflösung ausgibt, oder eine img2img-Erweiterung, die Referenzbilder unmittelbar einbindet. Die deterministische Kontrolle aus Blender bleibt dabei erhalten; nur der interpretierende Teil wächst — um genau die Schritte, die der Workflow braucht.
Für wen RAY-L gemacht ist
RAY-L richtet sich an alle, die bereits gewohnt sind, Bilder systematisch zu konstruieren und zu kontrollieren: Produktvisualisierer, Werbefotografen, Architekturvisualisierer, Designer, Art Directors. An Menschen, deren Frage nicht lautet "welches Modell liefert die beeindruckendsten Zufallsergebnisse", sondern: "wie produziere ich morgen dasselbe Bild mit einem anderen Produkt, in einer anderen Stimmung — verlässlich, nicht ungefähr."
Vorausgesetzt wird kein Expertenwissen, aber ein Grundverständnis beider Welten hilft: wie Blender als Kompositionswerkzeug funktioniert, ist im Bereich 3D & Blender beschrieben. Wie Diffusionsmodelle arbeiten und was ControlNet leistet, im Bereich KI.
Lizenz und Verantwortung
RAY-L ist eine Brücke, kein Modell-Anbieter. Welches KI-Modell innerhalb von RAY-L genutzt wird — und unter welcher Lizenz das geschieht — liegt in der eigenen Verantwortung der Anwendenden. Mehr dazu im Artikel zu Lizenzmodellen im KI-Bereich.
Aktueller Stand
Zielplattform ist vor allem Windows mit Nvidia-Hardware, die für ComfyUI-Workflows typische Plattform — RAY-L läuft aber auf beiden Plattformen stabil, auch auf macOS mit Apple Silicon. Die Windows-Kompatibilität ist inzwischen ausreichend getestet: auf realer Hardware bis hinunter zu einer sieben Jahre alten Karte mit 8 GB VRAM.
Aktuell steht RAY-L in Version 0.9 als Beta bereit, über Gumroad mit „Zahl, was du willst" — ab 0 $. Die Einrichtung ist damit spürbar einfacher geworden: Frühere Versionen berechneten die Canny-Kanten in Blender und verlangten dafür einen Eingriff in dessen Python-Umgebung, der andere Plug-ins stören konnte. In 0.9 entstehen die Kanten in ComfyUI — dieser Schritt entfällt.
Aktuell zuverlässig unterstützt: SDXL, Flux.1 dev und Flux.1 Krea dev, jeweils mit funktionierendem ControlNet Canny — auf beiden Plattformen bestätigt. Flux.1 dev ist dabei die neutrale Basis, Krea dev die fotografische Empfehlung desselben Slots auf identischer Pipeline. Für Flux.2 dev existieren die Canny-Adapter bereits, bei rund 40 Minuten pro Bild ist es aber kein iterativer Workflow. Als Nächstes kommt in v1.0 die Tiefeninformation aus der Szene (Depth Pass). Mehr dazu im Bereich KI, im Artikel zu den Modelltypen.
In Kürze folgt das Update v0.9.1: Im Flux-Modus bekommt das Panel zwei Prompt-Felder, eines für CLIP-L-Stichworte und eines für T5-Prosa, jeweils an den passenden Encoder. Noch nicht verifiziert sind die quantisierten GGUF-Varianten von Flux.1 dev und Krea dev — der Weg, der die Modelle auf knappem Speicher (etwa einem Mac mit 16 GB) überhaupt praktikabel macht. Wenn der laufende Test es verlangt, rüstet v0.9.1 die GGUF-Unterstützung mit nach.
Was als Nächstes hier entsteht
Dieser Bereich wächst in den kommenden Wochen weiter — von der Funktionsweise von ControlNet Canny im Detail über den vollständigen Workflow von Blender bis zum fertigen Bild, Installation und Setup, bis zu Anleitungen für weitere Modelle. Die modellspezifischen Anleitungen zu Flux.1 dev und Krea dev stehen bereits.
Wer den aktuellen Stand und neue Inhalte nicht verpassen will: die Startseite zeigt jeweils die zuletzt aktualisierten Bereiche.
RAY-L Beta