KI · Modellspezifische Setups
Flux.2 — Klein
Schneller als SDXL, besser als Flux.1 dev — in zwei Varianten, für zwei Hardwareklassen.
Das Schweizer Taschenmesser unter den Diffusionsmodellen
Meine Tests haben mit Flux.2 dev begonnen — dem Flaggschiff der Reihe, 32 Milliarden Parameter, und nach allem was man liest der aktuelle Stand der Technik bei KI-Bildgenerierung. Auf dem MacBook Pro mit 64 GB Unified Memory läuft es. Aber mit Renderzeiten um die 40 Minuten pro Bild ist das kein Workflow — das ist Warten. Flux.2 dev ist für lokalen Betrieb auf normaler Hardware schlicht nicht gemacht.
Klein 9B war der nächste Schritt. Kleiner, schneller — aber der Encoder für 9B ist 16,4 GB groß, das Modell selbst nochmal knapp 10 GB. Modell und Encoder müssen gleichzeitig in den Speicher, dazu Stability Matrix und ein Browser. Auf 16 GB nicht praktikabel.
Klein 4B war die Überraschung. Und Klein als Modellfamilie ist seither meine erste Empfehlung für alle Workflows ohne ControlNet.
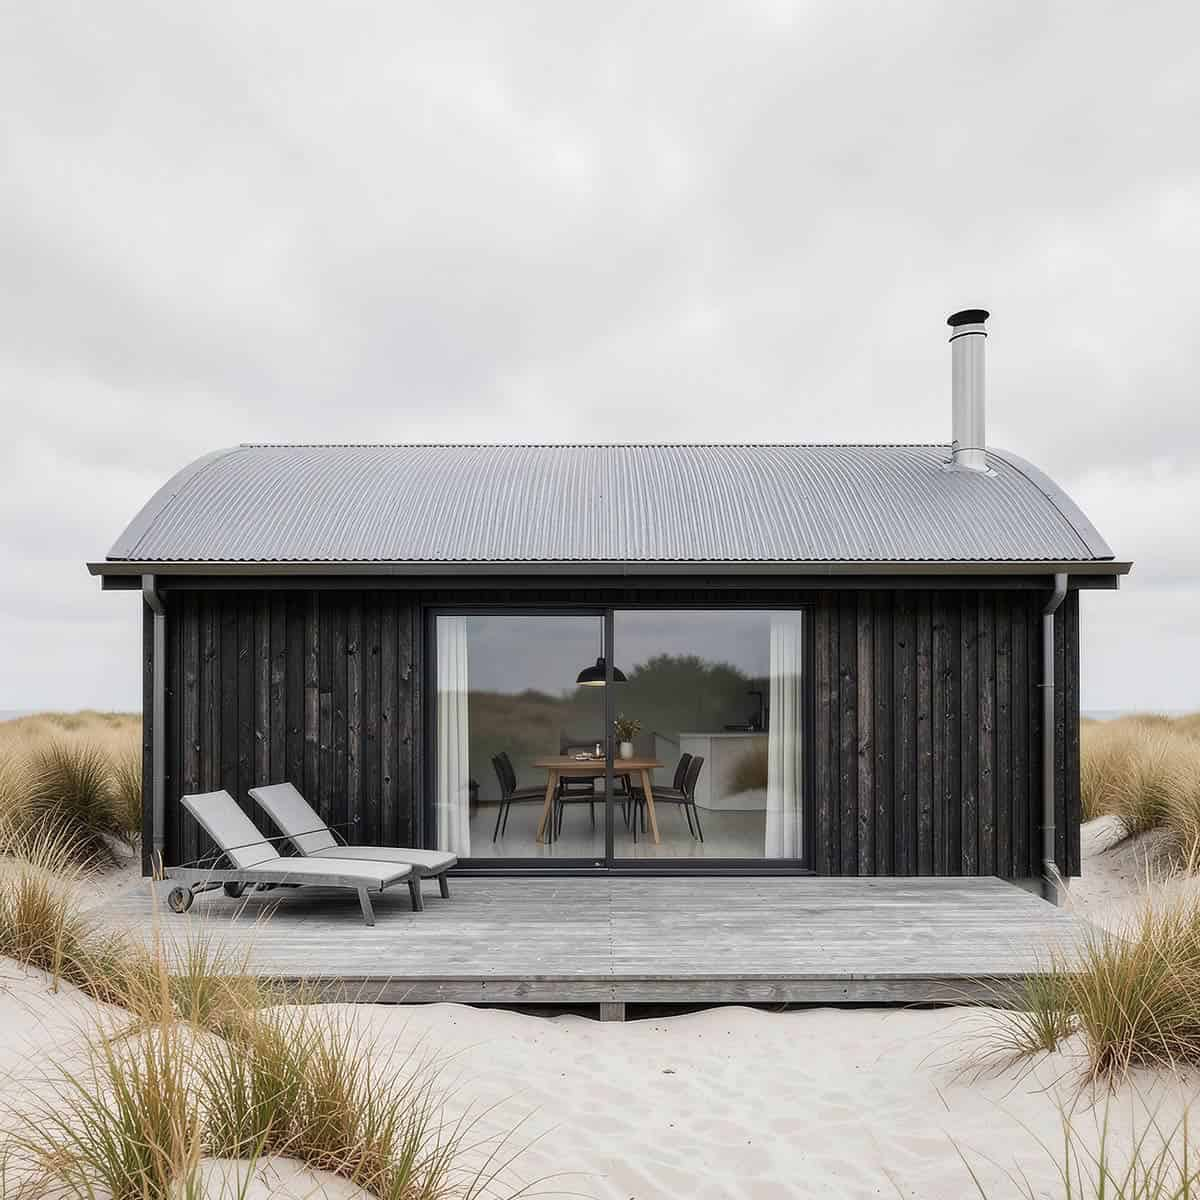
Flux.2 Klein 4B
Was Klein ist
Klein 4B und 9B sind distillierte Modelle — trainiert darauf, in 4 Steps zu einem Ergebnis zu kommen, das einem vollständigen Flux-Durchlauf in 20–25 Steps entspricht. Der Geschwindigkeitsvorteil ist keine Vereinfachung, sondern eine andere Trainingslogik.
Von beiden Größen gibt es zwei Formen: die distillierten 4-Step-Modelle — die hier gemeint sind — und undistillierte Base-Varianten (~50 Steps, guidance-regelbar), die nur fürs Fine-Tuning und LoRA-Training gebraucht werden. Beim Download unbedingt die distillierte Variante nehmen: Das Base-Modell liefert bei 4 Steps nur Matsch.
Beide Größen arbeiten mit demselben Encoder-Typ: Qwen 3, ein großes Sprachmodell. Kein CLIP, kein T5-Split, kein Zwei-Felder-Interface. Ein Textfeld, durchgehende Prosa. Die Prompt-Logik aus 2.4.3 — Prompts für Flux ist direkt übertragbar.
Der entscheidende Unterschied zwischen 4B und 9B ist nicht das Diffusionsmodell allein — es ist der Encoder. Bei 4B: 3,66 GB (Q6) oder 8 GB (BF16). Bei 9B: 16,4 GB in BF16 — größer als das Diffusionsmodell selbst. Das macht 9B auf 16 GB zu einem Grenzfall, und zu keinem empfehlenswerten.
Was es leistet
Die Messwerte — alle bei 1024×1024, warm (Modelle im Speicher):
| Modell | MacBook Pro 64 GB | MacBook Air 16 GB |
| SDXL | 143 s | ~300 s |
| Flux.1 dev | 360 s | — (OOM) |
| Klein 4B | 36 s | 90 s |
| Klein 9B | 75–85 s | — (nicht praktikabel) |
Klein 4B gegen Flux.1 dev: Faktor 10. Gegen SDXL auf dem Air: Faktor 3,3 — auf einer Maschine, auf der Flux.1 dev gar nicht erst läuft. Klein 9B liegt gut doppelt so lang wie 4B, bleibt aber noch deutlich schneller als Flux.1 dev.
Was meine Tests zusätzlich gezeigt haben: Beide Klein-Varianten liefern bessere Ergebnisse als Flux.1 dev — durchgängig, nicht als Einzelfall. Bei Deko-Elementen, bei Lichtrichtung, bei Materialübergängen. Ein Modell mit einem Drittel der Parameter, das in einem Zehntel der Zeit rechnet und dabei qualitativ überzeugt — das war das eigentliche Aha-Erlebnis dieser Tests.
Flux.1 dev ist mit 12 Milliarden Parametern dreimal so groß wie Klein 4B und rechnet zehnmal so lang. Dass Klein dabei qualitativ nicht zurückfällt, sondern vorne liegt, spricht dafür dass Flux.2 architektonisch etwas anders macht — nicht nur kleiner skaliert.
4B oder 9B?
Auf den ersten Blick sind die Ergebnisse beider Varianten nahezu identisch. Im Detail ist 9B präziser — realistischere Spiegelungen, feinere Objektformen, weniger Verformungen bei kleinen freistehenden Objekten. Im direkten Vergleich zeigt sich das erst im Zoom: Stühle auf einer Terrasse, bei 4B mit leicht deformierten Rädern bei 300 % Ansicht, bei 9B durchgehend präzise.
Ob dieser Unterschied im Ausgabeformat sichtbar ist, hängt vom Motiv und von der Abnahmegröße ab. Für Druckformate wo jedes Detail zählt, kann 9B das Abnahmemodell sein — 4B das schnelle Suchmodell davor. Dieselbe Zwei-Modell-Logik wie heute SDXL und Flux.1 dev, eine Generation weiter.
Für 16 GB Hardware ist die Entscheidung einfach: Klein 4B. Der 9B-Encoder allein belegt 16,4 GB — das ist vor dem Diffusionsmodell schon das gesamte verfügbare Budget.
Klein 4B
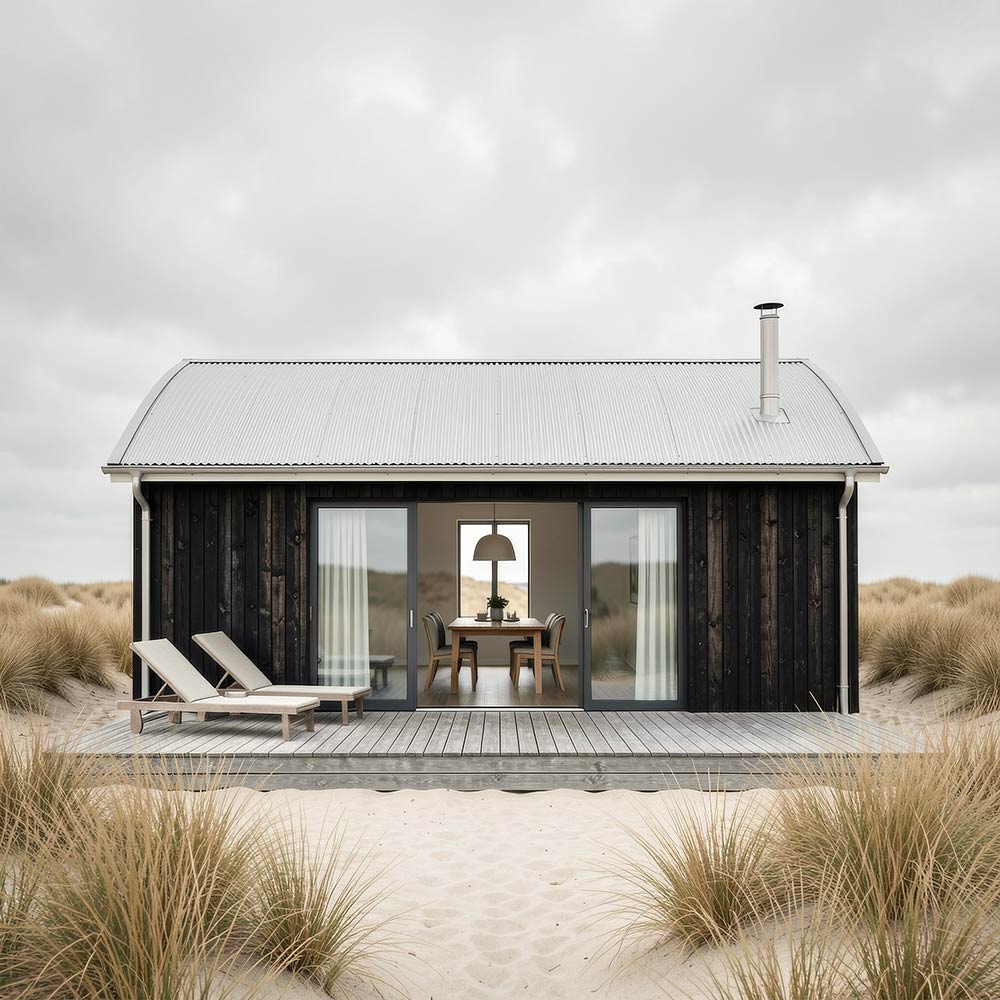
Klein 9B
Setup
Klein 4B — Dateien und Zielordner
16 GB (MacBook Air) — 90 s warm:
| Datei | Größe | Zielordner |
| flux-2-klein-4b-Q8_0.gguf | 4,3 GB | diffusion_models/ |
| Qwen3-4B-UD-Q6_K_XL.gguf | 3,66 GB | text_encoders/ |
| flux2-vae.safetensors | ~335 MB | vae/ |
Gesamtbedarf ~8,3 GB. Stability Matrix und Browser-Tabs können offen bleiben — kein Aufräumen nötig.
64 GB (MacBook Pro) — 36 s warm:
Gleiche Konfiguration, wahlweise mit qwen_3_4b.safetensors (BF16, 8 GB) statt dem quantisierten Encoder. Das Diffusionsmodell bleibt in jedem Fall GGUF — der Custom Node und das Python-Package müssen also unabhängig von der Encoder-Wahl installiert werden.
Klein 9B — Dateien und Zielordner
Gegenüber 4B ändern sich nur zwei Dateien — VAE, Steps, CFG und Sampler bleiben identisch. Nur für 64 GB empfohlen.
| Datei | Größe | Zielordner |
| flux-2-klein-9b-Q8_0.gguf | 9,98 GB | diffusion_models/ |
| qwen_3_8b.safetensors | 16,4 GB | text_encoders/ |
| flux2-vae.safetensors | ~335 MB | vae/ |
Wichtig: Der 9B-Encoder ist eine safetensors-Datei, kein GGUF — dafür den normalen CLIPLoader verwenden, nicht den GGUF-Loader. Im selben Repository liegen fp8mixed- und fp4mixed-Varianten — beide auf Apple Silicon unbrauchbar.
Bezugsquellen
| Datei | Repository |
| flux-2-klein-4b-Q8_0.gguf | unsloth/FLUX.2-klein-4B-GGUF |
| Qwen3-4B-UD-Q6_K_XL.gguf | unsloth/Qwen3-4B-GGUF |
| qwen_3_4b.safetensors (BF16) | Comfy-Org/vae-text-encorder-for-flux-klein-4b → split_files/text_encoders/ |
| flux-2-klein-9b-Q8_0.gguf | unsloth/FLUX.2-klein-9B-GGUF |
| qwen_3_8b.safetensors | Comfy-Org/vae-text-encorder-for-flux-klein-9b → nicht fp8mixed oder fp4mixed! |
| flux2-vae.safetensors | Comfy-Org/flux2-dev → split_files/vae/ |
Nodes in ComfyUI
Klein braucht andere Nodes als Flux.1 dev. Der Loader richtet sich nach dem Dateiformat des Encoders — nicht nach dem Modell:
| Aufgabe | Node |
| Diffusionsmodell laden (4B + 9B) | Unet Loader (GGUF) — nicht Load Diffusion Model |
| Encoder 4B GGUF | CLIPLoader (GGUF), type = flux2 |
| Encoder 4B BF16 / Encoder 9B | CLIPLoader, type = flux2 |
| Text eingeben | CLIP Text Encode — nicht CLIPTextEncodeFlux |
Kein Zwei-Felder-Interface, kein clip_l/t5xxl-Split. Ein Textfeld.
MPS-Regel
Alles mit fp8 oder fp4 im Dateinamen ist auf Apple Silicon nicht lauffähig — MPS kann diese Formate nicht rechnen. Die offizielle ComfyUI-Dokumentation verlinkt genau diese Dateien als Standard. Stattdessen: BF16 oder GGUF verwenden.
Pflichtschritt: GGUF-Support einrichten
Das Diffusionsmodell liegt im GGUF-Format — einem Quantisierungsformat das ursprünglich aus dem LLM-Bereich kommt. ComfyUI kann GGUF-Dateien nicht nativ laden; dafür braucht es einen Custom Node (ComfyUI-GGUF von city96) und ein Python-Package.
Schritt 1 — Python-Package installieren
Stability Matrix → ComfyUI-Package → Drei-Punkte-Menü → Python Packages → + → gguf suchen → installieren. Dieser Schritt muss zuerst erfolgen.
Schritt 2 — Custom Node installieren
ComfyUI → Manager → Custom Nodes Manager → GGUF suchen → ComfyUI-GGUF von city96 installieren. Auf den Autor achten — es gibt Nachbauten.
Danach ComfyUI stoppen und neu starten. Prüfen: Rechtsklick auf die Leinwand → Add Node → bootleg → Unet Loader (GGUF) — wenn der Node erscheint, ist alles korrekt installiert.
Der häufigste Fehler: der Custom Node installiert sich ohne Fehlermeldung, taucht aber nirgends auf. Ursache ist fast immer das fehlende Python-Package — deshalb Schritt 1 zuerst. Auf beiden Testmaschinen aufgetreten — kein Sonderfall.
Parameter
Gelten für beide Varianten — 4B und 9B. CFG 1.0 bedeutet: kein funktionierender negativer Prompt. Unerwünschtes positiv umformulieren — genau wie bei Flux.1 dev, nur noch konsequenter.
Steps:      4  (Flux2Scheduler)
CFG:        1.0  (CFG Guider)
Sampler:    euler
Scheduler:  simple
Lizenz
Bei Klein hängt die Lizenz an der Modellgröße. Flux.2 Klein 4B steht unter Apache 2.0 — permissiv: Modell und Outputs dürfen frei genutzt werden, auch kommerziell und in Produktion, ohne separate Lizenz. Flux.2 Klein 9B (und Flux.2 dev) stehen dagegen unter der FLUX Non-Commercial License von Black Forest Labs — derselben Urkunde wie Flux.1 dev und Krea dev.
Für die 9B-Variante gilt damit dieselbe Trennung wie bei dev und Krea: Die erzeugten Bilder gehören dem Anwender und dürfen für jeden Zweck genutzt und verkauft werden — Ausnahme ist allein das Training eines konkurrierenden Modells. Der kommerzielle oder produktive Betrieb des Modells braucht dagegen eine separate Lizenz von Black Forest Labs. Bei der 4B-Variante stellt sich diese Frage nicht.
Unabhängig von der Modellgröße gilt: KI-erzeugte Bilder sind gesetzlich als solche zu kennzeichnen, soweit anwendbar.
Mehr dazu in 2.1.4 — Lizenzmodelle verstehen. Maßgeblich ist die jeweils aktuelle Fassung auf bfl.ai; Orientierung, keine Rechtsberatung.
Und RAY-L?
Klein hat mich so überzeugt, dass die Integration in RAY-L beschlossen ist — sobald ControlNet Canny verfügbar ist. Das ist die einzige offene Flanke: Für Klein existiert aktuell kein ComfyUI-taugliches ControlNet Canny, weder für 4B noch für 9B.
Was es gibt, passt nicht: Ein diffusers-basierter ControlNet-Ansatz für 9B hat keinen ComfyUI-Node — RAY-L spricht ComfyUI. Ein weiterer Ansatz setzt zwingend ein Referenzbild voraus und fusioniert dessen Identität mit der Canny-Kontur, was nicht dasselbe ist wie "Geometrie fest, Material frei". Und Flux.2 dev hat ControlNet Canny — aber bei 40 Minuten Renderzeit ist das kein Argument.
Für RAY-L v1.0 bleibt Flux.1 dev gesetzt. Für alle Workflows ohne ControlNet — Verfeinerungen, img2img, freie Generierung — ist Klein ab jetzt die erste Wahl. Wenn ControlNet Canny für Klein kommt, kommt die Integration.
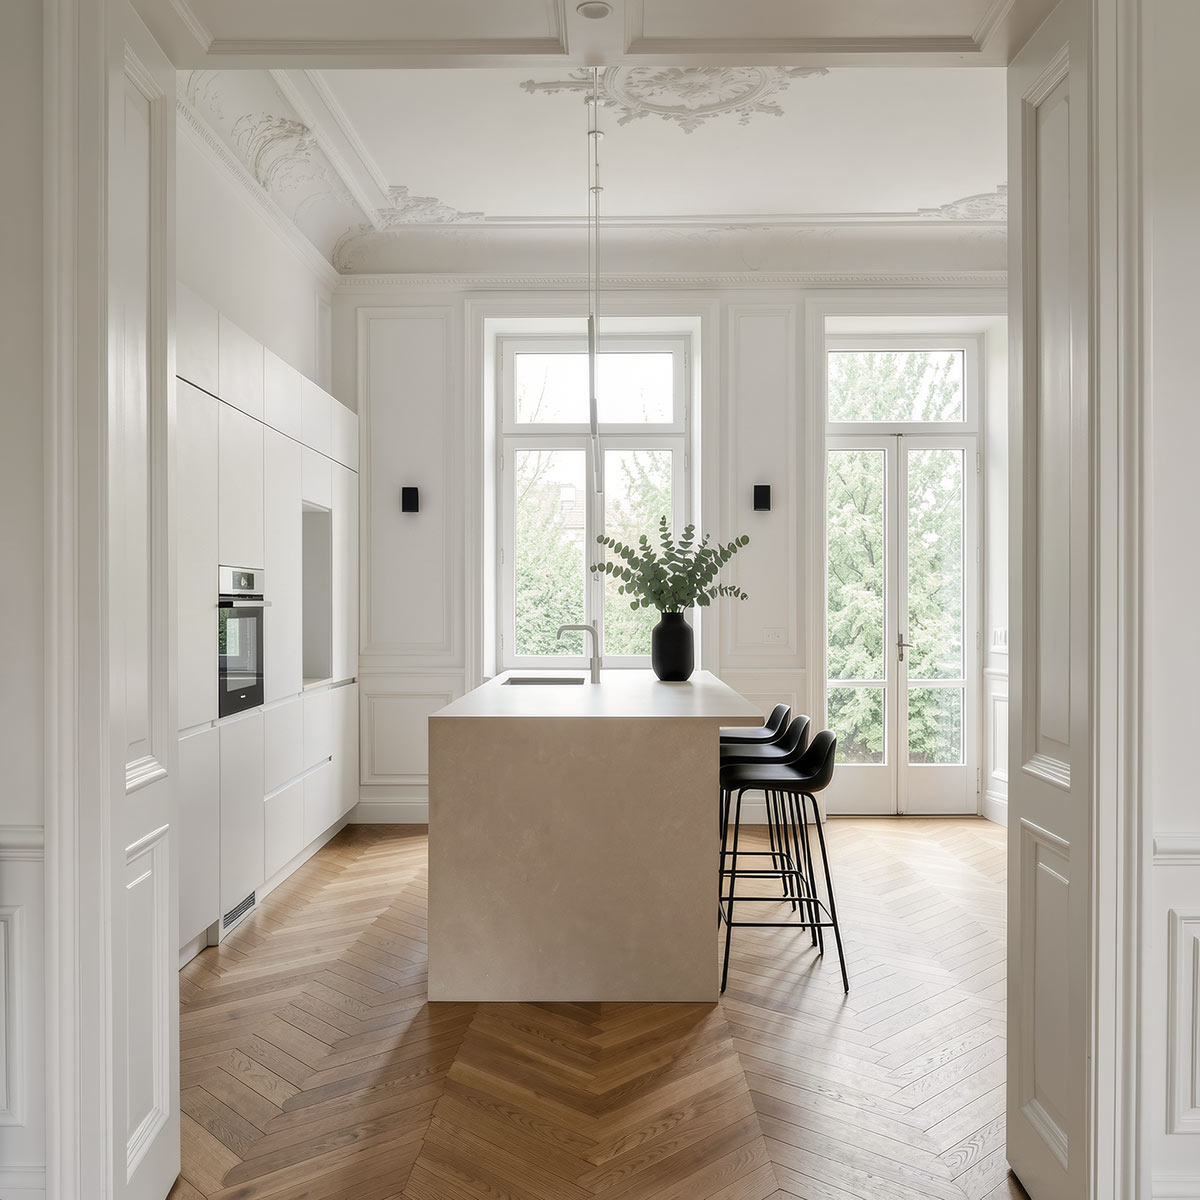
Flux.2 Klein 9B